
11 ноября 2026 года Tether AI Research выложила BotPsy-0.8B: модель на 0.8 млрд параметров поверх Qwen3.5-0.8B, дообученную вызывать инструменты и держать агентный диалог на устройстве. Если локальному боту нужны календарь, поиск, файлы или почта без облачного ключа, id уже есть. Разбор, таблицы и ограничения лежат в посте на Hugging Face. За организацией на площадке стоит QVAC, юридически это Tether Data.
Веса открытые, лицензия Apache 2.0. BF16 в safetensors: qvac/BotPsy-0.8B, его берут Transformers и vLLM. Три GGUF для llama.cpp и QVAC SDK: qvac/BotPsy-0.8B-GGUFs. Архитектура родительская: гибрид Gated DeltaNet и gated attention от Qwen3.5. Код обучения не выложен, датасеты перечислены в карточке.
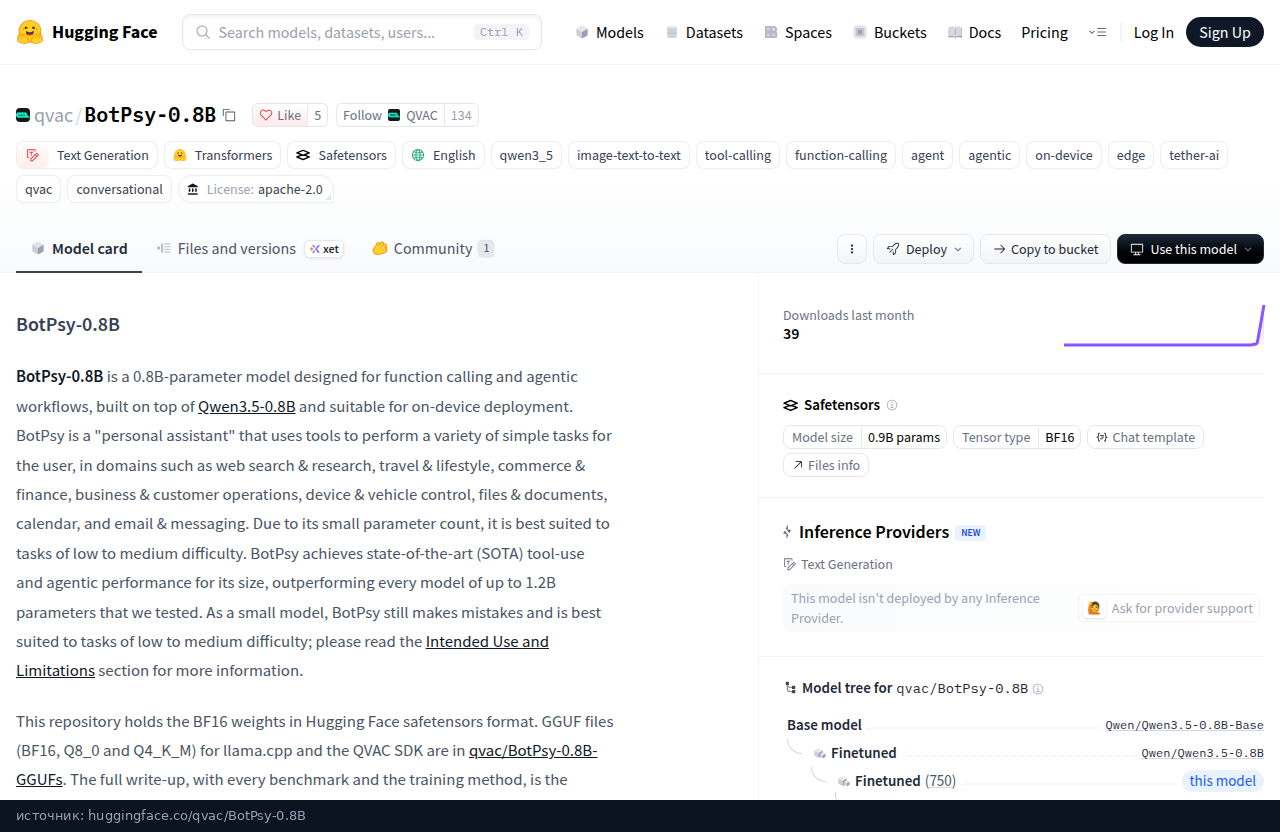
Три GGUF: 1.52, 0.81 и 0.53 ГБ
В репозитории GGUF три файла. Слои multi-token prediction базовой Qwen туда не вошли.
botpsy-0.8b-bf16.gguf, 1.52 ГБ, без квантования.botpsy-0.8b-q8_0.gguf, 0.81 ГБ. В карточке это основной файл.botpsy-0.8b-q4_k_m-imat.gguf, 0.53 ГБ, Q4_K_M с калибровкой imatrix.
Q8_0 гоняли тем же набором, что и пост, но уже через llama.cpp, 6 и 7 ноября 2026. По десяти тестам средний балл 50.7 против 50.4 у BF16 GGUF и 50.6 у исходного BF16 на vLLM. Файл при этом примерно вдвое меньше. На девяти тестах из десяти Q8 держится в пределах пункта от BF16 GGUF, на IFBench на 1.9 выше. ToolSandbox в этот прогон GGUF не входил.
Q4_K_M в среднем на 48.9, около полутора пунктов ниже BF16 GGUF. Вызов инструментов держится ближе: BFCL v4 43.5, ACEBench 57.3, τ-bench 46.7. Знания проседают сильнее. MMLU-Pro 42.5 против 46.0 у BF16 GGUF, GPQA Diamond 35.3 против 39.2. Если память не впритык, карточка советует Q8_0.
Тот же неквантованный BF16 в llama.cpp и в vLLM расходится на несколько пунктов. На τ-bench у GGUF 47.5 против 51.5 в посте, на Claw-Eval 43.4 против 46.5, на MMLU-Pro 46.0 против 48.9. Это движок и разброс прогонов, не квантование.
BFCL 44.0 и соседние тесты
Цифры ниже из их стенда, не из чужого рейтинга. Пять моделей, все в режиме thinking: BotPsy-0.8B, база Qwen3.5-0.8B-Think, Qwen3.5-2B-Think (в 2.5 раза больше), LFM2.5-1.2B-Think и MiniCPM5-1B-Think. BotPsy крутили на этих BF16 через vLLM. Замеры, где нужен внешний API, стоят на 3 ноября 2026.
По шести агентным тестам средний балл 45.0 против 24.7 у базы и 38.8 у Qwen3.5-2B-Think. BFCL v4: 44.0 против 23.4 и 37.7. ACEBench: 58.7 против 30.1 и 55.4. τ-bench (среднее retail, telecom и banking, без airline): 51.5 против 23.2 и 46.5. ToolSandbox: 64.6 против 30.5 и 41.2. На пяти из шести она выше модели в 2.5 раза крупнее. На Claw-Eval впереди как раз 2B: 48.9 против 46.5 у BotPsy и 39.3 у базы.
Самый заметный прирост в длинном диалоге. Многоходовый BFCL v4 вырос с 7.5 до 46.1, у Qwen3.5-2B-Think там 23.8. На τ²-bench в telecom, где агент много ходов ведёт человека по инструкции, 82.5 против 69.3 у 2B. В retail 67.8 против 33.9 у базы и 65.5 у 2B. Когда подходящего инструмента нет, на BFCL 86.1, выше всех в этой таблице. На кривых запросах ACEBench, где не хватает параметра или инструмент не тот, 51.3 против 13.7 у базы, но 2B тут выше: 58.0.
Инструкции подтянули сильно: IFEval 90.8 против 59.7 у базы и 80.0 у 2B, IFBench 55.9 против 22.0 и 40.9. Знания тоже выросли, GPQA Diamond с 33.2 до 38.1, MMLU-Pro с 41.6 до 48.9, и среди моделей до 1.2B в их таблице это верх. Размер всё равно решает: у Qwen3.5-2B-Think на тех же тестах 59.9 и 65.5. Сами пишут, что факты она должна доставать инструментом, а не помнить. На верных ответах рассуждение короче базы: около 3690 токенов на GPQA Diamond против 11563 и 1912 на MMLU-Pro против 5105. Доля зацикливаний на IFBench упала с 22.9% до 1.4%, упор в лимит 32 тысячи токенов с 28.3% до 0.2%.
Шаблон чата без thinking
Учили и мерили с thinking. Шаблон чата по умолчанию его выключает, поэтому в запросе нужно enable_thinking=true. Иначе это другой режим, не тот, по которому собрана таблица. Сэмплинг из карточки: temperature 0.3, top_p 0.95, top_k 20, presence_penalty 1.5. Первые три параметра лежат в generation_config.json, штраф за повтор туда не попал: в vLLM и llama.cpp его передают отдельно. Перед ответом модель пишет блок thinking, в карточке GGUF советуют не резать генерацию ниже 2048 токенов. В замере потолок был 32768 новых токенов.
Для llama.cpp в карточке рекомендуют Q8 и такой запуск. Контекст в примере 32768. У QVAC SDK в примере контекст короче, 8192, thinking включается через reasoning_budget: -1. SDK проверяли на @qvac/sdk 0.23.0.
hf download qvac/BotPsy-0.8B-GGUFs botpsy-0.8b-q8_0.gguf --local-dir .
llama-server -m botpsy-0.8b-q8_0.gguf --jinja -c 32768 \
    --temp 0.3 --top-p 0.95 --top-k 20 --presence-penalty 1.5 \
    --chat-template-kwargs '{"enable_thinking": true}' --port 8080
vLLM из карточки safetensors: vllm serve qvac/BotPsy-0.8B --language-model-only --enable-auto-tool-choice --tool-call-parser qwen3_xml --reasoning-parser qwen3. В теле запроса те же temperature, top_p, top_k, presence_penalty и enable_thinking в chat_template_kwargs. Transformers проверяли на 5.19.0. Быстрые ядра Gated DeltaNet хотят пакеты flash-linear-attention и causal-conv1d, без них остаётся медленный запасной путь. Вызов инструмента приходит в XML-формате Qwen3.5.
Русский, поиск и банк
Учили и советуют её на английском. На Multi-IF, три хода и восемь языков, общий балл 67.2, рядом с Qwen3.5-2B-Think (66.9) и чуть ниже LFM2.5-1.2B-Think (68.2). Первый ход самый сильный из пятёрки, 84.3, к третьему падает до 51.0, у тех двух моделей на третьем ходе 56.5 и 56.2. По-русски 57.6, по-хинди 24.5. По английскому, китайскому, французскому, испанскому, итальянскому и португальскому у них от 72 до 80.
Один вызов инструмента она держит ровнее, чем цепочку. По простым сценариям общий балл 75 против 54 у базы и 70 у 2B. По сложным, несколько ходов или несколько инструментов, 39.5 против 17.9 и 30.8. Добыча фактов в несколько шагов остаётся дырой: сложный поиск около 15 при 79 на одном вызове. BrowseComp-Plus 4.5, лучший результат из пяти и всё равно низкий. Веб-поиск BFCL 14.0 против 19.8 у 2B, память 16.3 против 26.1. Банковский τ³ не берёт никто: у BotPsy 4.1, как у базы, у 2B 4.8, выше пяти нет ни у кого.
В автоматическом редтиме по шести категориям вреда небезопасный ответ у BotPsy в 21% прогонов, у базы в 36%. Среди моделей до 1.2B в их сравнении это минимум: у LFM2.5-1.2B-Think 35%, у MiniCPM5-1B-Think 47%. Если в вывод инструмента подмешана чужая инструкция, доля падает с 46% у базы до 31%. Для агента, который читает чужие страницы и сам пишет в календарь или почту, это всё ещё часто. На боевой сайт, SSH и платежи её ставить не стоит. Сами ограничивают задачи низкой и средней сложности и прямо не советуют решения, где на кону деньги, здоровье и личные данные.
Рецепт обучения короткий. База Qwen3.5-0.8B, четыре стадии: дообучение на диалогах с вызовами, дистилляция с трёх учителей Qwen3.5-4B (инструменты, рассуждения, инструкции), затем два раунда обучения с подкреплением. Награда за вызов смотрит имя инструмента и аргументы, не только попадание целиком. После первого этапа знания и следование инструкциям просели ниже базы, дистилляция вернула их наверх, два раунда RL добавили ещё. Для одного вызова, календаря и простых дел локально размер как раз такой. Длинный поиск, банк и всё, где ошибка стоит денег, эта модель не закрывает.

