

5 ноября команда Celery выпустила версию 5.7.0. Это библиотека, через которую Django- и Flask-проекты отправляют письма, собирают отчёты и выполняют другие долгие задачи в фоне, не заставляя пользователя ждать ответа страницы. Новых громких функций в релизе немного, зато много исправлений там, где Celery обычно подводит в продакшене: при обрыве связи с брокером, падении процессов и переходе на зимнее время.
Если у вас на сервере крутятся воркеры Celery, перед обновлением стоит проверить версию Python и пару настроек. Ниже о том, что изменилось и что включить по желанию.
Python 3.9 больше не поддерживается
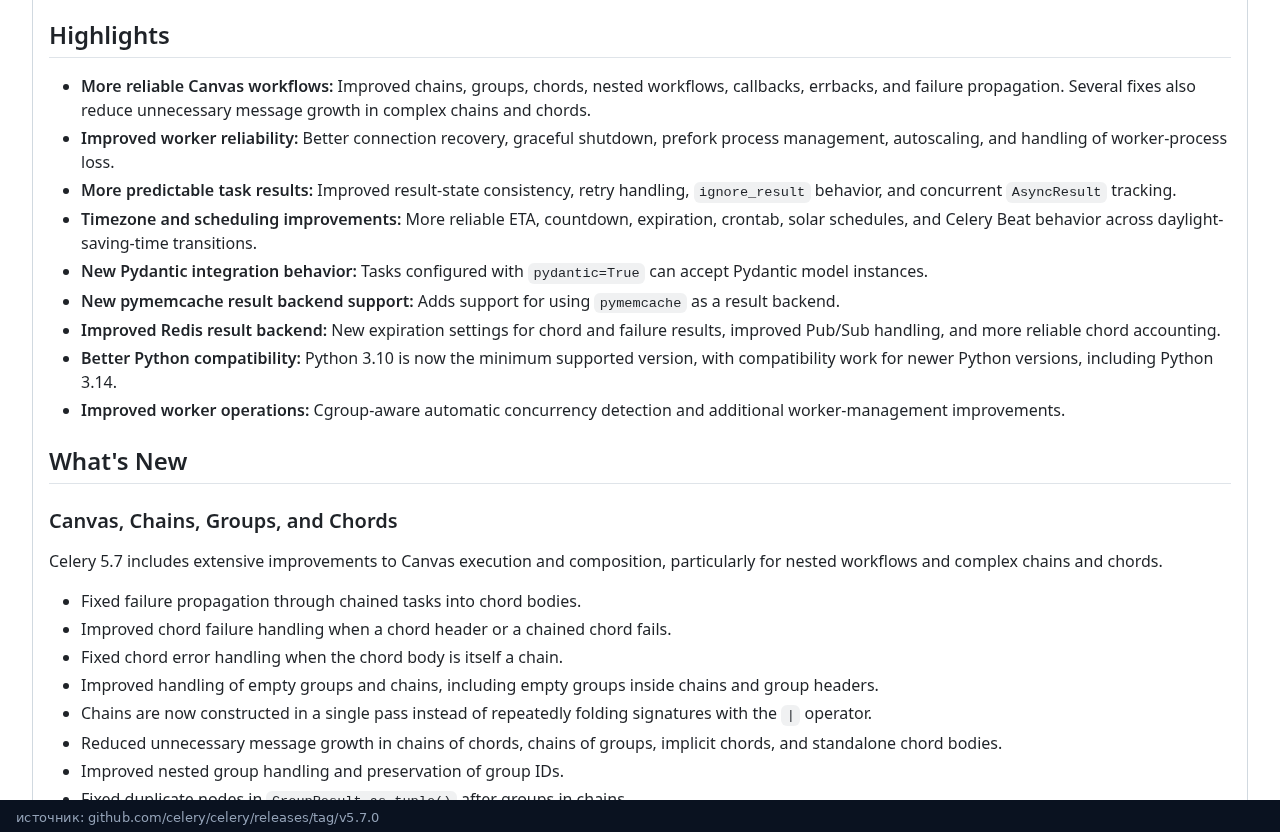
Celery 5.7 работает только на Python 3.10 и новее. Если проект ещё живёт на 3.9, pip просто оставит вам 5.6.x, и новая версия не встанет. Вместе с Celery обновляются её зависимости: нужна Kombu 5.7.0 (она отвечает за работу с RabbitMQ и Redis) и Billiard не ниже 4.3.1. В дополнении для сжатия Brotli пакет brotlipy заменили на brotlicffi. Заодно поправили совместимость с Python 3.14.
Обновление и быстрая проверка выглядят так:
python --version
python -m pip install --upgrade "celery[redis]==5.7.0"
celery --version
celery -A proj report
Вместо proj подставьте имя своего приложения. Команда report покажет версии Celery, Kombu и Python, а также настройки брокера, так что сразу видно, что подхватилось.
Что проверить перед обновлением
В разделе Upgrade Notes разработчики перечисляют, на что обратить внимание. Самое заметное касается подтверждения задач. Раньше одна настройка task_acks_on_failure_or_timeout решала сразу за два случая: задача упала с ошибкой и задача превысила лимит времени. Теперь их можно настроить по отдельности через task_acks_on_failure и task_acks_on_timeout. Например, упавшую задачу подтвердить и больше не трогать, а зависшую по таймауту вернуть в очередь.
Если новые настройки не задавать, Celery берёт значение из старой, так что поведение не меняется. Сама старая настройка объявлена устаревшей, и её стоит постепенно заменить двумя новыми.

Ещё одно изменение может тихо поменять поведение кода. Раньше timeout=0 в wait_for, ResultSet.join() и get_many() означал бесконечное ожидание. Теперь ноль понимается буквально: если результата ещё нет, таймаут сработает сразу. Если где-то в коде ноль стоял как «ждать сколько угодно», замените его на None.
Тем, кто хранит результаты в Redis, пригодятся две новые настройки: result_chord_expires задаёт, сколько живут служебные ключи групп задач (chord), а result_failure_expires позволяет хранить результаты упавших задач дольше или меньше обычных.
Воркер может сам подстроиться под лимиты контейнера
Классическая проблема: контейнеру выделили два ядра, а на хосте их 32. Celery по умолчанию смотрит на все ядра машины и запускает 32 процесса, которые потом дерутся за два ядра. В 5.7 появилось значение --concurrency=auto (или worker_concurrency = "auto" в настройках). С ним Celery учитывает, какие ядра процессу реально доступны (taskset, docker run --cpuset-cpus), и читает квоту процессора из cgroup, как первой, так и второй версии. Если квоты заданы на нескольких уровнях, например на поде и на slice в systemd, берётся самая строгая.

Режим включается только явно, по умолчанию всё работает как раньше. Ограничение по квоте применяется к пулу prefork, где задачи выполняются отдельными процессами. Для пулов threads, gevent, eventlet и solo значение auto просто равно числу доступных ядер. Если ваш код сам читает app.conf.worker_concurrency, учтите, что там теперь может оказаться строка "auto".
Задача после гибели процесса больше не ходит по кругу
Раньше с настройкой task_reject_on_worker_lost задача, чей процесс убили, возвращалась в очередь без всякого лимита: брокер не считает такие возвраты. Если задача стабильно съедает всю память и её убивает OOM killer, она могла крутиться бесконечно. Новая настройка task_retry_on_worker_lost вместо этого отправляет задачу повторно так же, как Task.retry(). Значит, действуют обычные max_retries и default_retry_delay (по умолчанию 180 секунд), а когда попытки кончатся, задача будет помечена как упавшая.

Важная оговорка из документации: настройка помогает, только когда погиб дочерний процесс пула, а главный процесс воркера остался жив. Если OOM killer убил весь контейнер, повторять задачу некому. По умолчанию настройка выключена. Включить её вместе с автоподбором процессов можно так:
# celeryconfig.py
worker_concurrency = "auto"
task_retry_on_worker_lost = True
Расписания Beat и переход на зимнее время
Большой блок исправлений касается времени. Отложенные задачи (ETA и countdown), сроки истечения, расписания crontab и solar раньше могли сбиваться в дни перевода часов. В 5.7 это поправили во многих местах сразу. Для России перевода часов нет, но если сервер или пользователи живут в другом часовом поясе, разница будет заметна.
Сам планировщик Beat тоже стал спокойнее: если одна запись расписания выбрасывает исключение, Beat продолжает работать с остальными, а невозможные даты в crontab отклоняются сразу. Появилась и проверка живости Beat через inspect ping, её нужно включать отдельно.
Мелочи, которые пригодятся в работе
- У
AsyncResultпоявился методexists(): можно узнать, есть ли результат задачи в хранилище. - Задачи с
pydantic=Trueтеперь принимают готовые модели Pydantic, а не только словари. - Результаты можно хранить в Memcached через библиотеку pymemcache.
- Если две разные функции зарегистрированы под одним именем задачи, Celery предупредит об этом, а повторный
@shared_taskна одной функции вызовет понятную ошибку. - Пароли в адресах брокера и ключи Azure лучше скрываются в выводе
celery inspectи диагностике.
Если коротко: Celery 5.7 стоит ставить тем, у кого воркеры работают в контейнерах или регулярно падают по памяти, ради --concurrency=auto и task_retry_on_worker_lost. Перед обновлением убедитесь, что проект на Python 3.10 или новее, поищите в коде timeout=0 и посмотрите, как у вас настроено подтверждение задач. Обновлять лучше сначала на тестовом стенде, вместе с Kombu.
