
2 октября 2026 ТАСС со ссылкой на Yandex B2B Tech сообщил, что «Яндекс» запустил гибридный поиск: одновременно по точному совпадению символов и по смыслу. За новостью стоит конкретный релиз. Это СУБД YDB версии 26.3, в которой к векторному поиску добавили полнотекстовый с ранжированием BM25 и функцию HybridRank, сводящую обе выдачи в один SQL-запрос. Подробности команда YDB в тот же день разобрала на Хабре, синтаксис и ограничения описаны в документации YDB.
Для тех, кто собирает RAG или поиск по базе знаний, смысл простой: номер документа, код ошибки или артикул ищутся точно, описание проблемы ищется по смыслу, и всё это в одной базе, без отдельного поискового движка и векторного хранилища рядом. В компании называют технологию не имеющей аналогов в России, это заявление Яндекса.
Зачем два поиска: номер полиса точно, описание случая по смыслу
Пример у Яндекса страховой. В ТАСС это запрос агента в CRM «выплаты по полису 7702-345678 при ДТП с пострадавшими», в статье команды YDB тот же полис, но «при переносе рейса». Номер полиса надо найти символ в символ, а суть случая понять по смыслу.
- векторный поиск сравнивает эмбеддинги и находит «договор аренды нежилого помещения» по запросу «соглашение о найме коммерческой недвижимости», но может упустить редкую фамилию или номер, а «152-ФЗ» и «153-ФЗ» для него почти одно и то же;
- полнотекстовый поиск находит фамилию, код ошибки и номер точно, приводит «суд», «суда» и «судом» к одной основе, но синонимы для него разные слова;
- гибридный поиск запускает обе ветви и объединяет результаты в одну выдачу.
Технический директор YDB Андрей Фомичёв в комментарии Хабру назвал главной инженерной задачей именно объединение и ранжирование двух выдач. Оба индекса лежат рядом с данными и обновляются в той же транзакции.
Как устроено: два обычных индекса и HybridRank в ORDER BY
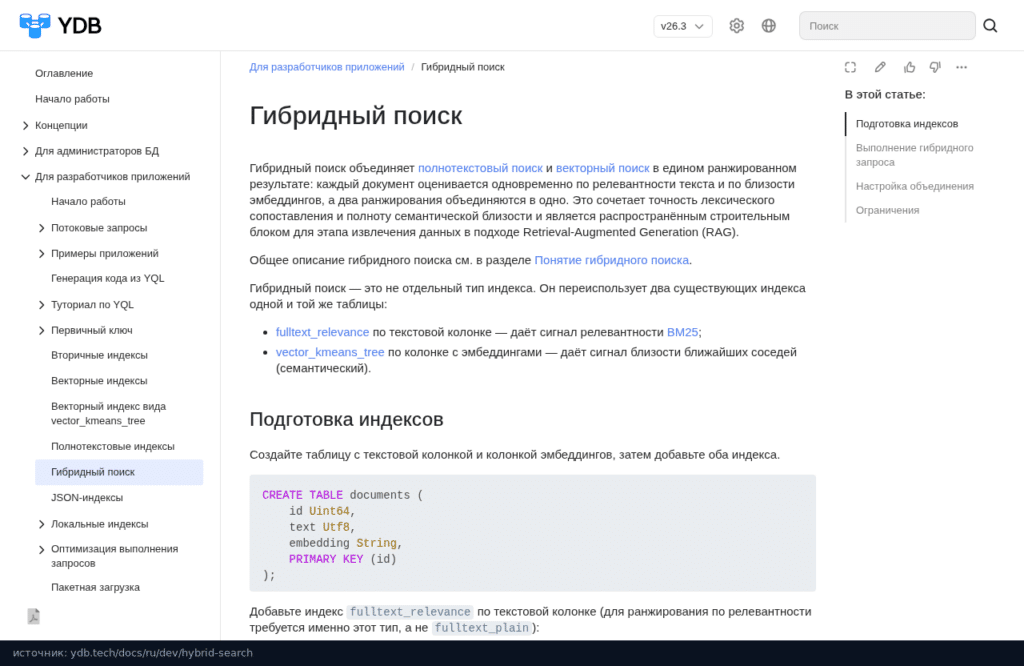
Отдельного «гибридного» индекса нет. По документации запрос использует два существующих индекса одной таблицы: fulltext_relevance по текстовой колонке (оценка BM25) и vector_kmeans_tree по колонке с эмбеддингами. Сам запрос обычный SELECT по таблице, без VIEW, а единственный ключ сортировки это HybridRank:
SELECT id, text
FROM documents
ORDER BY HybridRank(
    FullTextScore(text, $queryText),
    Knn::CosineDistance(embedding, $queryVector))
LIMIT 10;
- эмбеддинги YDB сама не считает, вектор запроса передаёт приложение из своей модели;
- каждая ветвь отбирает пул кандидатов, по умолчанию в 10 раз больше
LIMIT; что не попало в пул, объединение уже не поднимет; - по умолчанию выдачи сводятся методом Reciprocal Rank Fusion с константой 60 и равными весами; есть режим
linearс весамиWeightsи собственные лямбдыRankLambdaиScoreLambda; LIMITдолжен быть литералом (или задайтеLimits), префиксные векторные индексы пока не поддерживаются,HybridRankнельзя комбинировать с другими ключами сортировки.
Разница в поведении индексов при записи важна для эксплуатации. Полнотекстовый индекс после каждой транзакции остаётся точным. Векторный раскладывает новые строки по уже построенным кластерам, центроиды не пересчитываются, поэтому со временем полнота падает, и индекс перестраивают: рядом строят новый и атомарно подменяют старый. Для стемминга в опенсорс-версии используется Snowball, а клиентам Yandex Cloud и Enterprise-версии доступна морфология Яндекса.
Где доступно: облако с 23 сентября, в опенсорсе пока выключено по умолчанию
По словам команды YDB, полнотекстовый и гибридный поиск уже есть в опенсорсе, с 23 сентября доступны в Yandex Managed Service for YDB, в том числе в Serverless со стартовым тарифом, и в коммерческой сборке для установки в контуре компании. Пресс-служба в сообщении Хабру называет enterprise-редакцию 26.3 для установки on-premises и Managed Service for YDB.
В списке изменений YDB Server версия 26.3 пока числится релиз-кандидатом 26.3.1.16 от 18 сентября 2026, а гибридный поиск стоит в разделе функциональности, которая не включена по умолчанию. Полнотекстовые индексы включены по умолчанию с версии 26.2.1.14 от 16 сентября. Если поднимаете YDB у себя из открытых сборок, гибридный поиск придётся включать отдельно и пока на релиз-кандидате.
Что это меняет для RAG и поиска по базе знаний
Пресс-служба Яндекса противопоставляет это схеме, где рядом с базой работают отдельные поисковый движок и векторная база, а данные между ними приходится синхронизировать. Гибридный поиск в RAG и без YDB не новость: в заметке про Agentic RAG на LangGraph он собран на Qdrant из плотных эмбеддингов и разреженного BM25, а родительские чанки лежат отдельно, в JSON. YDB предлагает держать текст, эмбеддинги и оба индекса в одной транзакционной таблице, тогда выдача не расходится с данными: удалённая строка не вернётся ни из одной ветви.
Векторный поиск встраивают и в привычные СУБД, например тип VECTOR в MariaDB. У YDB главное в том, что объединение двух ранжирований происходит внутри одного плана запроса. Команда YDB обещает на вебинаре 15 октября собрать поиск по документам, тикетам, карточкам и диалогам и подключить его к ИИ-ассистенту, всё показанное, по её словам, доступно на бесплатном тарифе.
Итог такой. Новость ТАСС подтверждается: в YDB 26.3 есть гибридный поиск, полнотекстовая и векторная ветви работают в одном SQL-запросе через HybridRank, по умолчанию с RRF. В облаке функция работает с 23 сентября, а в открытой версии 26.3 пока релиз-кандидат, где гибридный поиск выключен по умолчанию. Слова «аналогов в России нет» остаются оценкой самого Яндекса. Это уже второй крупный рассказ Яндекса о поиске и рекомендациях за неделю, после модели Sona.
