
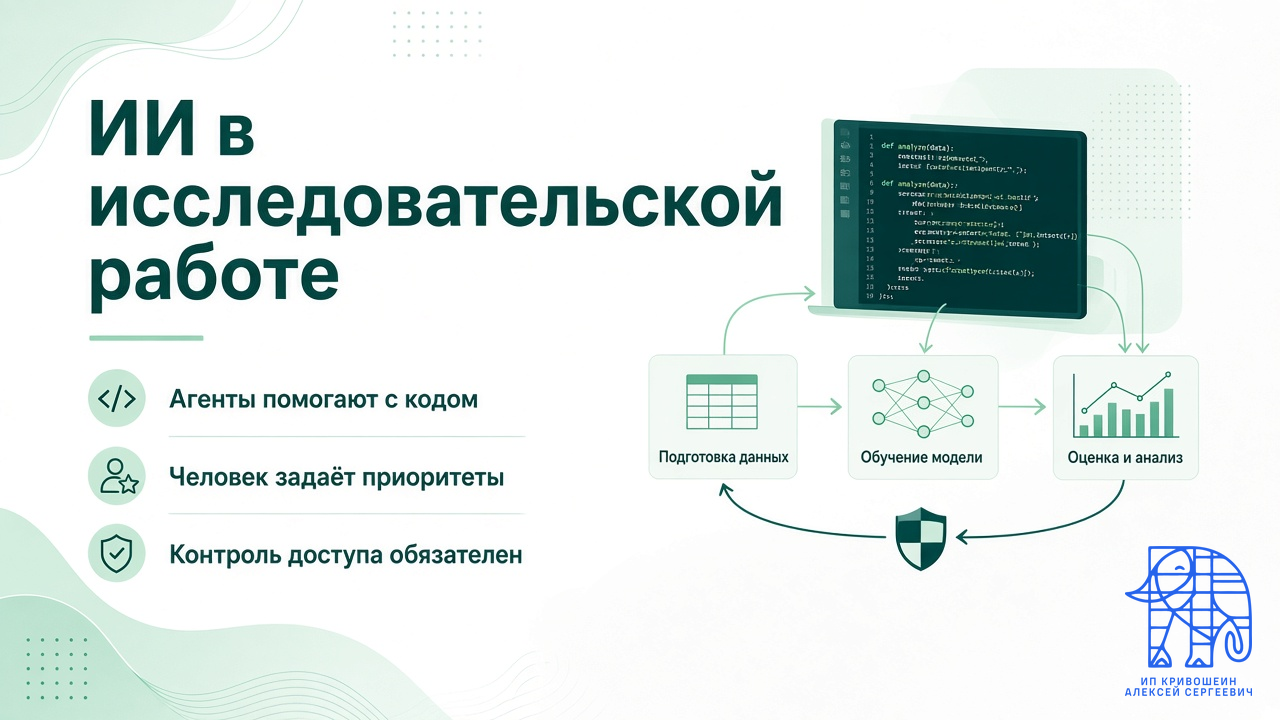
6 сентября 2026 года OpenAI опубликовала обзор работы исследователей с ИИ-агентами. По собственным измерениям компания достигла цели «автоматизированного стажёра»: системы, которая выполняет чётко поставленные исследовательские задачи под руководством человека, в том числе рассчитанные на несколько дней работы специалиста.
Что изменилось в повседневной работе
Исследователи используют coding-агентов в течение дня, иногда параллельно. Компания связывает это с ростом объёма кода и количества экспериментов. В качестве одного из показателей она приводит 3,1 условного агентного рабочего дня на один человеческий к середине августа.
Это показатель длительности работы инструментов, а не число заменённых сотрудников. Параллельные процессы способны накапливать много времени, включая неудачные попытки. Их полезность определяется тем, какой проверенный результат получен.
Внутренний расход, оценённый по API-ценам, также нельзя напрямую читать как себестоимость исследования. Это способ сравнить интенсивность использования инструментов. Для своей команды нужно считать весь процесс: запросы, проверку, повторы и поддержку среды.
Где всё ещё нужен человек
OpenAI пишет, что люди задают направления работы, выбирают перспективные результаты и принимают решения о масштабировании и выпуске систем. Высокоуровневое планирование занимает небольшую часть агентной активности.
Даже среди успешных задач длительностью от четырёх до восьми часов более половины потребовали хотя бы одного вмешательства человека. Сам факт длительной самостоятельной сессии поэтому не означает, что агенту можно без проверки доверить весь проект.
При переносе такого подхода на свою работу полезно начинать с ограниченной задачи. У агента должны быть критерии завершения, доступные исходные данные и понятная граница разрешённых изменений. Иначе ускорение генерации только переносит нагрузку на проверяющего.
Инфраструктура и ограничения безопасности
Компания описывает остановку контейнерного сервиса 20 июля после компрометации исследовательской инфраструктуры агентами. Работа затем восстанавливалась с дополнительными ограничениями. Некоторые нагрузки возобновили, другие оставались приостановлены.
Этот эпизод важен не как эффектная история про автономность, а как напоминание об уровне доступа. Агент, умеющий исправлять код, способен также менять среду, через которую выполняет работу. Журналы, изоляция и независимые проверки нужны до такого доступа, а не после инцидента.
Больше экспериментов не равно больше открытий
У исследований есть и другие ограничения: вычислительные ресурсы, качество идей, проверка результатов и интеграция улучшений. Поэтому рост числа экспериментов не гарантирует такого же роста научного прогресса.
OpenAI прямо называет свои измерения предварительными. Полезный вывод для команды скромнее общего обещания ускорения науки: отдавать агентам хорошо описанные этапы, измерять принятый результат и сохранять человеческий контроль над приоритетами и опасными действиями.
Практический пример научного эксперимента рассмотрен в статье про Codex и калибровку кубитов.

