

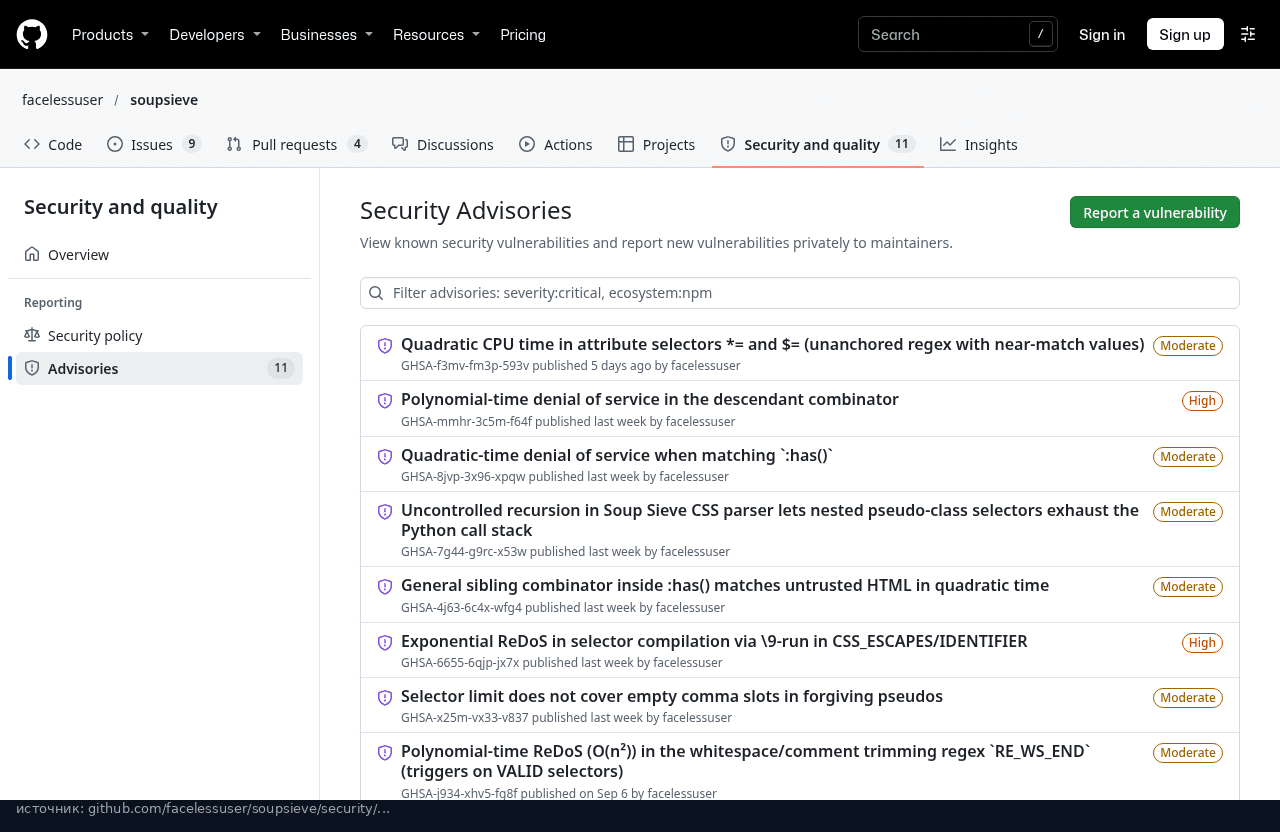
С 4 по 10 ноября разработчик Soup Sieve опубликовал на GitHub описания семи уязвимостей. Soup Sieve это библиотека, через которую Beautiful Soup ищет элементы по CSS-селекторам: на ней работают методы select(), select_one() и css.select(). Отдельно её обычно никто не ставит, она приезжает вместе с beautifulsoup4, поэтому про неё легко забыть.
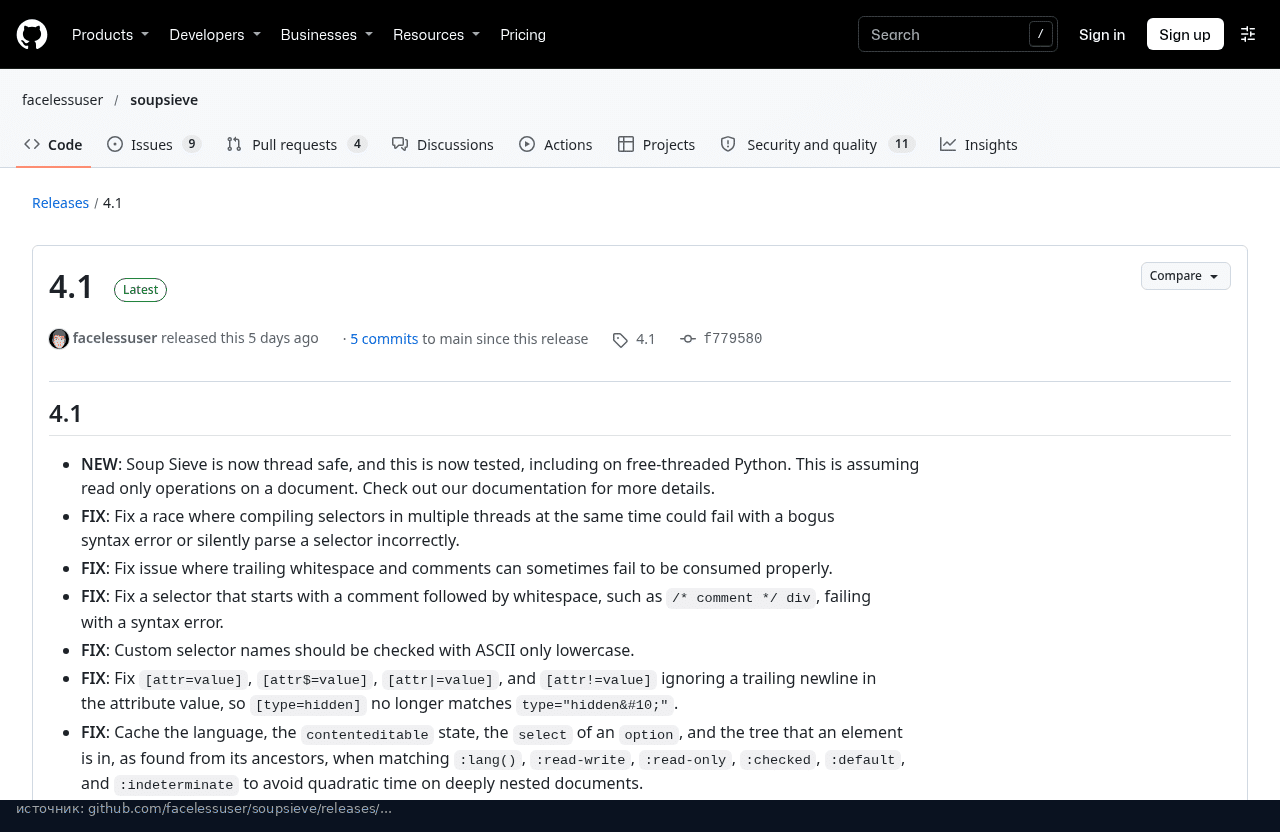
Почти все найденные проблемы относятся к отказу в обслуживании и устроены одинаково. Специально подготовленный HTML или селектор заставляет поиск работать секунды и минуты вместо долей секунды. Данные при этом не утекают и чужой код не запускается, но процесс, который разбирает такую страницу, полностью занят, и нескольких таких запросов хватит, чтобы сервис перестал отвечать. Исправления вышли в версиях 4.0 (3 ноября), 4.0.1 (4 ноября) и 4.1 (10 ноября).
Опасно это там, где HTML приходит снаружи: в парсерах чужих сайтов, при очистке пользовательского HTML, в сервисах, которые обрабатывают загруженную или скачанную разметку. Если select() работает только по вашим собственным страницам, бояться нечего. Методы find() и find_all() Soup Sieve не используют. 13 ноября описания попали и в общую базу уязвимостей GitHub, так что в проектах со старой версией скоро появятся предупреждения Dependabot.
Главная дыра: обычный селектор и глубоко вложенные теги
Самая серьёзная из уязвимостей, CVE-2026-126190 с оценкой 7.5 по CVSS, касается самого обычного селектора с пробелом, например section div. Чтобы его проверить, библиотека берёт каждый div и поднимается по всем его родителям в поисках section. Раньше результаты этих проходов нигде не запоминались, и одни и те же предки проверялись снова и снова. Хуже всего, когда нужного элемента на странице нет вовсе: тогда каждый проход идёт до самого верха документа, а с каждым лишним пробелом в селекторе время растёт ещё быстрее.
Цифры из описания уязвимости хорошо показывают масштаб. На версии 3.0.4 страница из 800 вложенных друг в друга div, то есть всего 4 КБ, с селектором section div div разбиралась 53 секунды. Страница в 1 КБ и селектор section div div div заняли 40,9 секунды. В 4.0 оба случая укладываются в сотую долю секунды. Повторить это можно в несколько строк:
import time
import bs4
import soupsieve as sv

# 200 вложенных div, около 1 КБ разметки
soup = bs4.BeautifulSoup("<div>" * 200, "html.parser")
t = time.process_time()
sv.select("section div div div", soup)
print(time.process_time() - t)  # на старых версиях десятки секунд

:has() и поиск по части атрибута
Вторая похожая проблема, CVE-2026-126189, связана с псевдоклассом :has(). Селектор вида div:has(p) на глубоко вложенной странице проверял одно и то же поддерево для каждого предка, а div:has(> p) > span заново перебирал всех детей для каждого ребёнка. Время в обоих случаях росло квадратично. Это исправлено в 4.0.1.
В 4.1 закрыли ещё одну медленную операцию: поиск по части значения атрибута, [attr*=value] и [attr$=value]. Если длинное значение в селекторе почти совпадает с длинным атрибутом на странице, проверка занимала заметное время: селектор на 20 КБ против атрибута на 80 КБ давал около секунды на каждый запрос. Теперь такое сравнение идёт обычным поиском подстроки. Заодно 4.1 стала потокобезопасной для чтения документа, в том числе на сборках Python без GIL, а [type=hidden] больше не находит type="hidden" с переводом строки в конце.
Старые дыры, которые описали только сейчас
Остальные четыре уязвимости исправили ещё летом и осенью, в версиях от 2.9.2 до 3.0, а описания опубликовали тоже 4 ноября. Три из них опасны там, где пользователи сами вводят селекторы: в сервисах парсинга, конструкторах без кода, настраиваемых правилах извлечения данных.
- CVE-2026-126191, оценка 7.5: селектор из повторяющихся экранированных цифр
\9заставлял регулярное выражение внутри библиотеки перебирать варианты очень долго. Строка примерно в 60 байт занимала около 10 секунд, и каждые лишние четыре символа увеличивали время примерно в 16 раз. Исправлено в 3.0. - CVE-2026-126193: глубоко вложенные друг в друга псевдоклассы исчерпывали стек вызовов Python. Исправлено в 3.0.
- CVE-2026-126192: селектор
:has(~ ...)на подготовленной странице работал квадратично долго. Исправлено в 2.10. - CVE-2026-126194: лимит на число селекторов не учитывал пустые места между запятыми внутри некоторых псевдоклассов, так что его можно было обойти. Исправлено в 2.9.2.
Как обновиться и при чём тут Python 3.10
Сначала стоит посмотреть, какая версия стоит в каждом окружении, где есть Beautiful Soup. Самому beautifulsoup4 обновляться не обязательно: он требует только soupsieve не ниже 1.6.1, так что новую версию можно поставить поверх. Актуальная версия на PyPI сейчас 4.1.
pip show soupsieve | grep -i version
python -m pip install -U "soupsieve>=4.1"

# в проекте на uv
uv lock --upgrade-package soupsieve
uv sync
Есть важная оговорка. По правилам проекта исправления выходят только для последней мажорной версии, а начиная с 3.0.4 Soup Sieve требует Python 3.11.5 или новее. На Python 3.10, который уже не поддерживается, pip поставит максимум 2.10, и трёх свежих исправлений из 4.0, 4.0.1 и 4.1 там не будет. Если парсер на 3.10 разбирает чужой HTML, это ещё один повод переехать на новую версию Python.

Пока обновиться нельзя, разработчик советует использовать в селекторах для чужих страниц как можно меньше пробелов между частями, а где структура документа известна, заменять их на >, то есть на поиск прямых потомков. Флаг NOCACHE в новых версиях возвращает старый медленный алгоритм, поэтому с чужим HTML его включать нельзя.
Что может измениться в результатах после 4.0
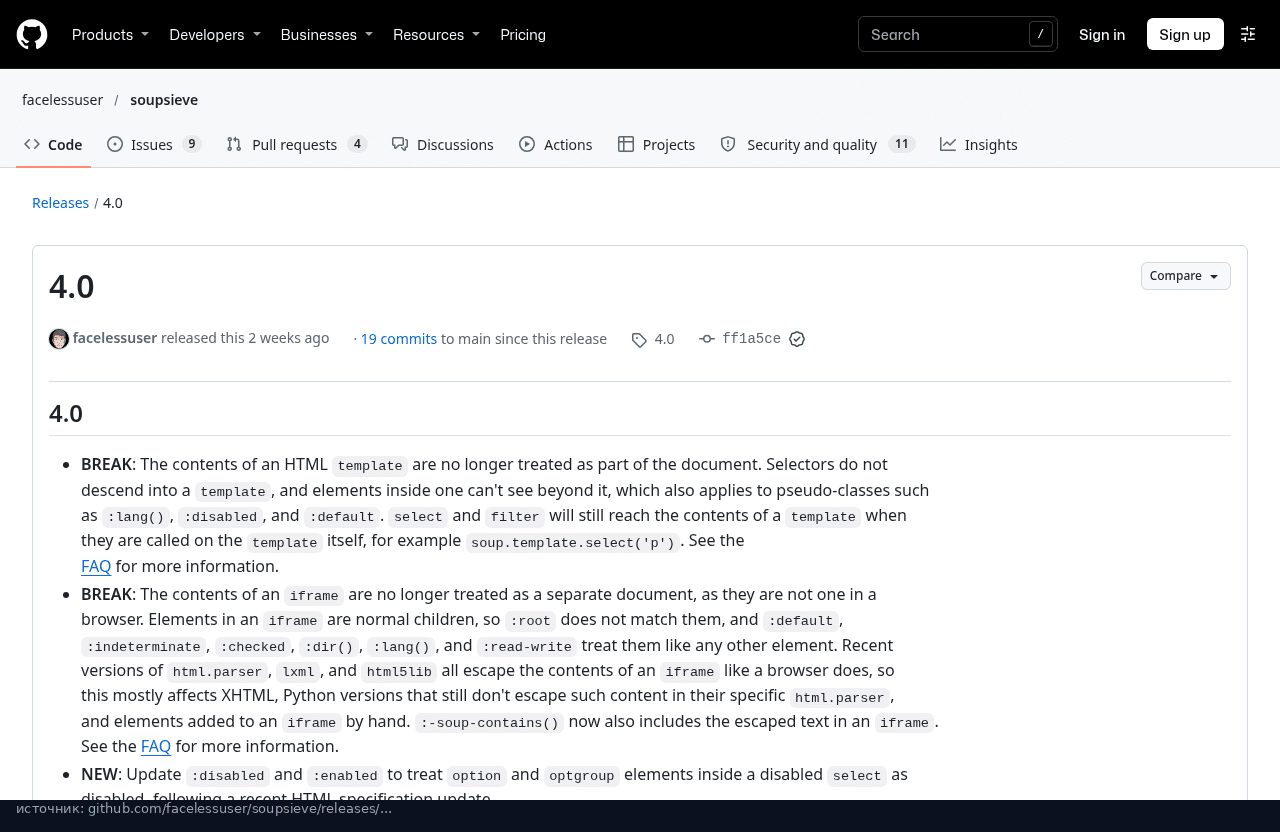
Версия 4.0 мажорная, и в ней есть два несовместимых изменения. Содержимое <template> больше не считается частью документа: селекторы туда не заходят, хотя soup.template.select("p") по-прежнему работает. А содержимое <iframe>, наоборот, больше не считается отдельным документом, его элементы теперь обычные потомки, и :root на них не срабатывает. Если парсер достаёт данные из шаблонов или фреймов, после обновления стоит прогнать его тесты.
Итог простой: если Beautiful Soup у вас разбирает HTML, который приходит снаружи, обновите Soup Sieve до 4.1 во всех окружениях и проверьте, не остались ли такие парсеры на Python 3.10. Для скриптов, которые работают только со своими страницами, обновление не срочное, но и откладывать его надолго незачем.

